
Une visioconférence se fige, les utilisateurs accusent le Wi-Fi et plusieurs équipements remontent des alertes. Pour l’équipe IT, le travail commence souvent par une question simple : quels événements décrivent la même panne, et lequel mérite d’être traité en premier ? Le nombre de notifications n’aide pas toujours à y répondre.
Meraki Actions propose de rapprocher ces signaux du diagnostic. Annoncé le 1er octobre 2026 en accès anticipé, ce nouvel espace du dashboard Meraki rassemble incidents, alertes et pistes d’optimisation. L’IA intervient pour résumer une situation, proposer une cause probable et orienter l’investigation.
Pour une entreprise, l’intérêt se mesure au temps nécessaire pour prendre une bonne décision. Un diagnostic présenté clairement peut accélérer une intervention ; une hypothèse convaincante mais mal vérifiée peut aussi entraîner un changement inutile. Voici comment évaluer cette nouveauté avec des critères d’exploitation concrets.
Ce qu’il faut retenir
- Actions est en Early Access, avec activation volontaire et déploiement progressif. Sa présence dans une organisation doit être vérifiée.
- L’espace réunit trois types de signaux : incidents, alertes et optimisations. Ils ne justifient pas tous la même urgence.
- Un résumé, des recommandations et un journal de raisonnement accompagnent l’investigation ; un agent peut approfondir l’analyse.
- Le bon pilote mesure la qualité des diagnostics et le rétablissement du service, pas seulement le nombre d’alertes traitées.
Trois signaux, trois décisions différentes
Une borne inaccessible, un problème persistant touchant de nombreux utilisateurs et un réglage perfectible doivent pouvoir cohabiter dans une même vue sans avoir la même priorité. C’est un point essentiel pour les structures multi-sites : la file de travail doit refléter l’impact métier, pas uniquement la date du dernier événement.
| Signal | Ce qu’il représente dans Actions | Réflexe d’exploitation conseillé |
|---|---|---|
| Incident | Un problème persistant, corrélé et à fort impact client | Qualifier le service touché et organiser sa restauration |
| Alerte | Un changement d’état susceptible de dégrader le réseau | Vérifier le contexte et le périmètre avant de modifier la configuration |
| Optimisation | Une amélioration proactive sans impact réseau actuel | Planifier un test dans une fenêtre adaptée |
Cette classification gagne à être reliée aux usages de l’entreprise. Un équipement secondaire indisponible peut être moins urgent qu’une connexion instable dans la seule salle accueillant une réunion client. Le nombre de terminaux affectés reste utile, mais la criticité du service et les horaires complètent la lecture technique.
Il faut aussi éviter qu’une proposition d’optimisation se transforme en intervention urgente. Lorsqu’un réseau fonctionne correctement, le bénéfice attendu doit être expliqué, le changement préparé et le retour arrière possible. Une file unifiée aide à organiser ce travail ; elle ne supprime pas le besoin d’arbitrage.
Une analyse utile doit montrer ses éléments de preuve
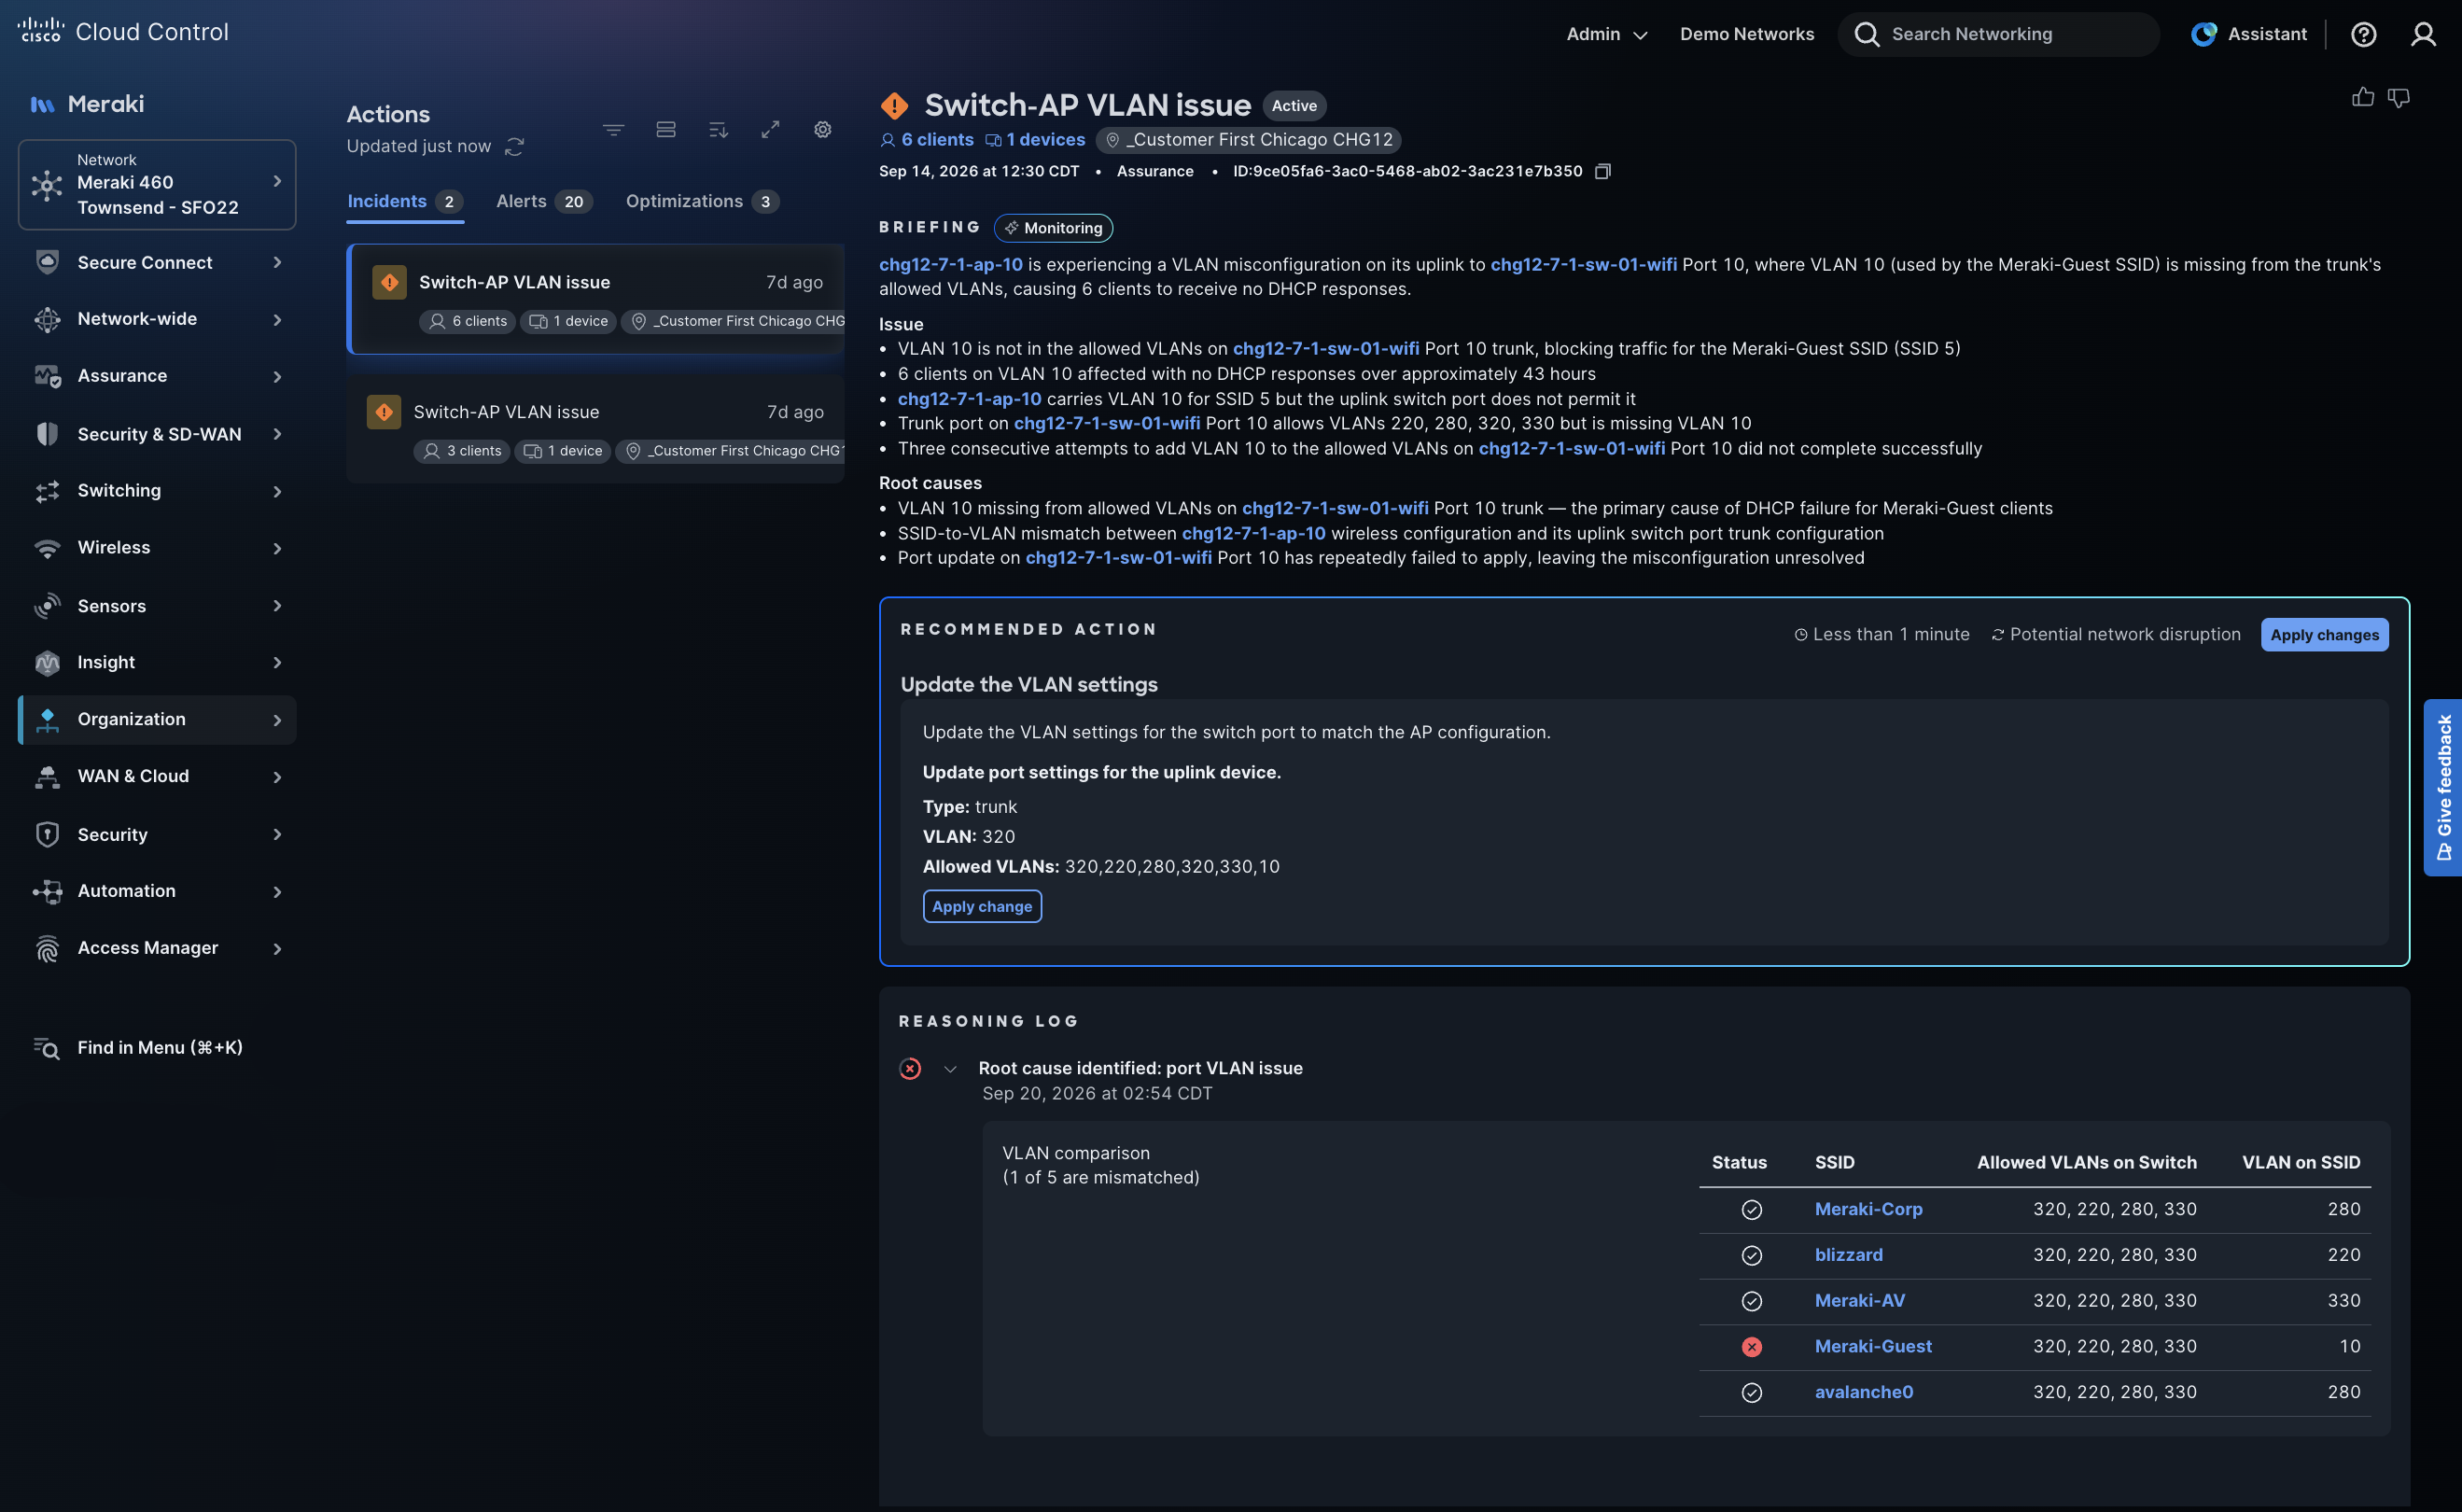
Actions présente un Briefing, des Recommended actions et un Reasoning log. Le résumé expose le problème ; les recommandations proposent une intervention et signalent notamment un risque de perturbation ; le journal permet de revenir aux éléments utilisés dans l’analyse. Ces fonctions donnent à l’administrateur de quoi examiner une proposition avant de l’exécuter.
La bonne question devient alors : « qu’est-ce qui permet de relier ce symptôme à cette cause ? » Il faut regarder les équipements et clients concernés, les horaires, les métriques dégradées et les changements récents. Une corrélation temporelle est un indice utile, mais elle doit rester cohérente avec le fonctionnement réel du réseau.
Prenons un exemple fictif : plusieurs ordinateurs perdent l’accès à une application après une modification de VLAN. Une hypothèse liée à la segmentation paraît plausible. Avant de changer un port, l’administrateur peut contrôler son rôle, le VLAN attendu, le chemin vers la passerelle et le périmètre des postes touchés. Si seuls les clients d’un service SaaS sont affectés, il faut aussi examiner la résolution DNS et la disponibilité de ce service.
Un journal de raisonnement est donc utile lorsqu’il permet de remonter aux observations. Sa présence, à elle seule, ne garantit pas que toutes les dépendances ont été vues. Une connexion opérateur, un terminal ou une application extérieure au périmètre observé peuvent encore nécessiter des contrôles complémentaires.
AgenticOps, MCP : deux usages à distinguer
Le mot « agent » recouvre ici une expérience intégrée au dashboard, centrée sur les problèmes de réseau. Notre article sur Meraki, Catalyst Center et MCP traite d’un autre usage : rendre l’infrastructure interrogeable depuis des outils compatibles avec ce protocole.
Dans Actions, le point de départ est un signal à examiner. Pour l’équipe de support, cela peut faciliter la continuité entre la détection, l’investigation et l’intervention. Le sujet du pilote est donc la qualité de ce parcours : comprend-on plus vite le problème ? Retrouve-t-on les observations ? La recommandation est-elle adaptée à ce site ?
L’expression « AgenticOps » ne suffit pas à décrire les droits effectifs d’un outil. Pour chaque intervention proposée, il faut examiner ce que le dashboard permet réellement de faire, qui dispose des autorisations et quels effets sont attendus. La gouvernance doit porter sur les opérations disponibles, plutôt que sur le vocabulaire commercial.
Early Access : vérifier l’accès et préparer l’équipe
L’activation est proposée depuis Organization > Early Access, ou depuis les entrées Organization > Alerts et Assurance > Alerts. L’expérience Actions remplace les entrées Alerts existantes. Les régions annoncées au lancement sont AMER, EMEA et APJC, avec une ouverture progressive sur les semaines suivantes.
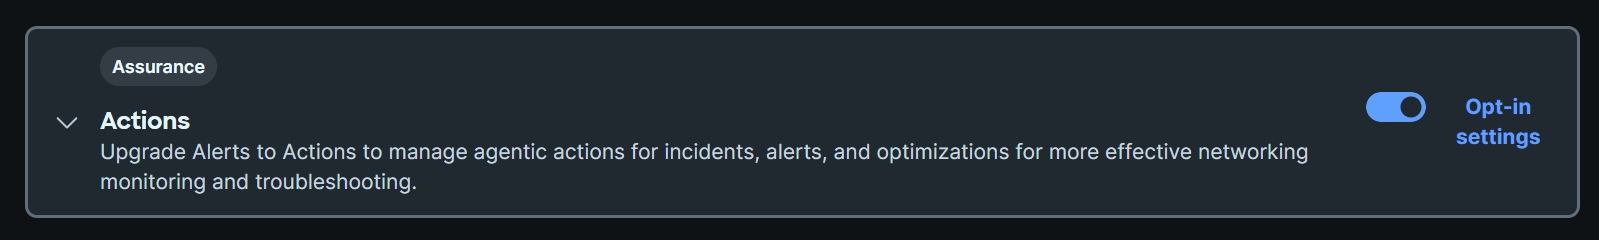
Au 5 octobre 2026, cette annonce ne permet donc pas de présumer que chaque organisation française voit déjà le bouton. Il faut vérifier sa disponibilité dans le dashboard concerné, puis informer les personnes qui utilisent habituellement la page d’alertes.
Avant un pilote, relire les droits, les destinataires de notifications, les webhooks et les horaires de maintenance est une précaution utile. Il s’agit de vérifier que le traitement des événements reste compatible avec le support existant. Les équipes qui structurent leur supervision peuvent compléter cette préparation avec notre article sur les alertes, webhooks et alternatives à SNMPv1 chez Meraki.
Après dix interactions quotidiennes avec l’agent de raisonnement approfondi, un message sensibilise l’administrateur à sa consommation, sans limite bloquante actuellement. Ce point mérite d’être suivi pendant le pilote ; il ne permet pas de prédire les futures conditions commerciales ou quotas.
Plan d’action recommandé : un pilote que l’on peut juger
Le pilote doit produire autre chose qu’une impression favorable devant une nouvelle interface. Nous recommandons de fixer une période d’observation et un périmètre représentatif, avec un responsable capable de rapprocher chaque proposition du ticket correspondant.
- Décrire la situation de départ. Relever le volume de sollicitations, le temps de qualification et les incidents récurrents. Choisir des mesures déjà accessibles plutôt qu’inventer un tableau de bord complexe.
- Conserver le contexte. Pour chaque cas étudié, noter le service touché, l’heure, le périmètre, l’hypothèse proposée et les observations qui la soutiennent.
- Examiner l’intervention. Vérifier sa portée, son risque de coupure et le moyen de revenir à l’état précédent. Une optimisation peut attendre une fenêtre de maintenance.
- Contrôler le résultat. Après intervention, tester le service depuis un poste concerné : accès à l’application, navigation ou appel vidéo selon le symptôme. Une modification appliquée et un service rétabli sont deux observations différentes.
- Comparer les cas. Mesurer le temps gagné, les investigations complémentaires nécessaires, les hypothèses écartées et les incidents rouverts. Examiner aussi les cas où l’outil n’a pas aidé.
Ces critères permettent de décider où Actions apporte de la valeur. Le pilote peut révéler un bon outil de qualification sans justifier pour autant toutes les interventions proposées. Il peut aussi montrer que la qualité de l’inventaire, des noms d’équipements ou de la documentation locale doit d’abord progresser.
Pour les entreprises disposant de plusieurs bureaux, cette méthode s’intègre à une démarche d’infogérance réseau : rendre les incidents compréhensibles, conserver leur historique et vérifier leur résolution. Le bénéfice recherché reste la disponibilité des usages, pas l’adoption d’un outil pour lui-même.
FAQ
Actions peut-il remplacer la procédure d’incident de l’entreprise ?
La procédure doit continuer à définir les responsables, l’escalade, les changements autorisés et les tests de rétablissement. Actions peut alimenter ce parcours. Le pilote sert à vérifier comment ses informations et ses recommandations s’intègrent aux tickets et aux responsabilités existantes.
Faut-il attendre la disponibilité générale pour s’y intéresser ?
Un accès anticipé peut être utile pour se former et tester un périmètre maîtrisé. En revanche, il est prématuré de faire dépendre une organisation de support entière d’une fonction dont la disponibilité et les conditions peuvent encore évoluer.
Quel premier cas choisir pour le pilote ?
Un problème connu et bien documenté permet de comparer l’analyse proposée à des observations déjà disponibles. Éviter de provoquer une panne en production uniquement pour tester l’outil ; un incident historique exploitable ou un environnement de test offre un meilleur point de départ.
Besoin d'aide ?
BoucheCousue vous aide à organiser la supervision de votre réseau Meraki et à évaluer Actions sur un périmètre maîtrisé, avec des critères de diagnostic et de rétablissement concrets.